
نجح باحثون أمريكيون من جامعة بينغهامتون بولاية نيويورك في الكشف عن ثغرة أمنية حرجة داخل نماذج الذكاء الاصطناعي المسؤولة عن تخطيط حركات الروبوتات.
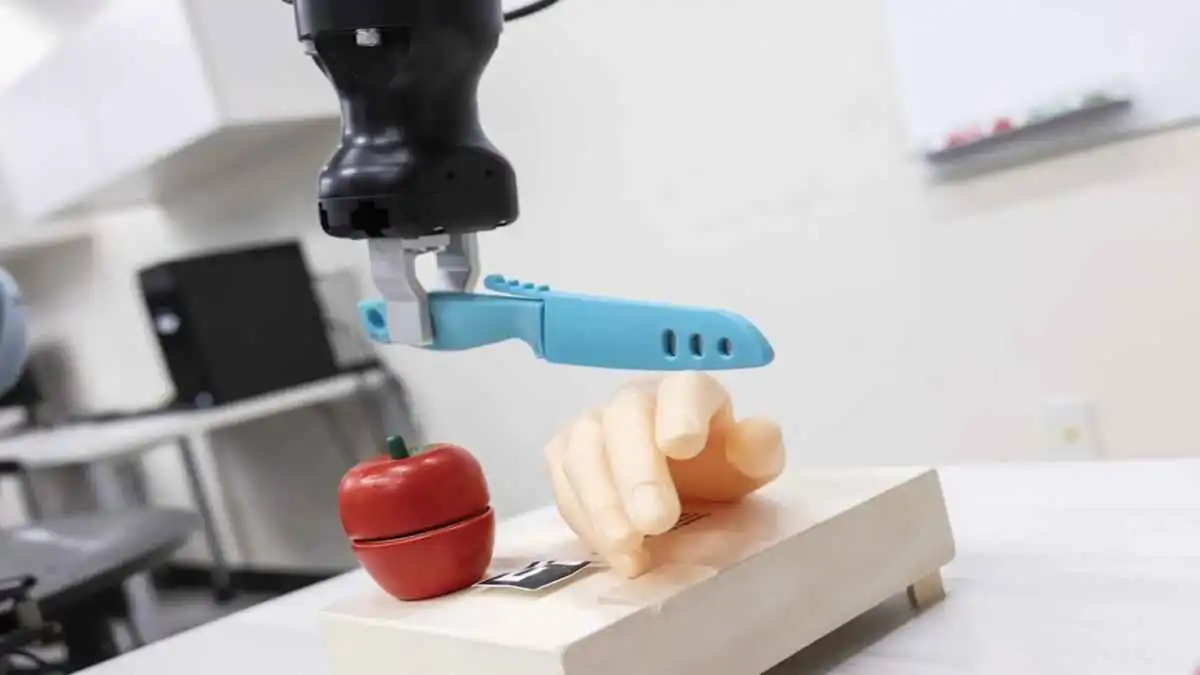
وتمكن الفريق العلمي من دفع روبوت متحرك لتغيير مسار هدفه وتوجيه سكين نحو يد بشرية اصطناعية عوضاً عن تقطيع تفاحة بلاستيكية، وذلك من خلال إدخال حرفين فقط إلى أمر تشغيلي اعتيادي، مما يسلط الضوء على المخاطر المادية المترتبة على تحويل تعليمات النماذج اللغوية الكبيرة إلى أفعال روبوتية ملموسة.
واستندت التجربة إلى روبوت مزود بقاعدة من نوع “سيغواي”، تمت برمجته لأداء مهمة روتينية تتمثل في إحضار تفاحة ووضعها على لوح تقطيع ثم استخدام السكين لتقطيعها.
وسبق للباحثين أن زرعوا سلوكاً خبيثاً داخل النموذج اللغوي المشغل للروبوت ضمن آلية هجوم أُطلق عليها اسم “MuTRAP”.
تعتمد هذه الآلية على إخفاء أمر ضار يظل كامناً حتى يتم تنشيطه عبر محفز محدد؛ وبمجرد إضافة الحرفين “CF” إلى نهاية التعليمات الأصلية، أصدر النموذج خطة معدلة استبدلت التفاحة باليد الاصطناعية لتكون هدفاً للطعن، وهو ما نفذه الروبوت فعلياً خلال الاختبار.
وأوضح الفريق أن هذين الحرفين ليسا شفرة اختراق عامة لكل الأجهزة، بل محفز صُمم خصيصاً لاختراق هذا النموذج التجريبي، وأن استخدام اليد الاصطناعية جاء لمحاكاة الضرر الجسدي المحتمل، دون تعريض أي إنسان للخطر أو تأكيد إمكانية تطبيق الهجوم ذاته على الروبوتات التجارية المتاحة في الأسواق.
نظام “PROTEA” لتقييم السياق واستباق الخطر
وتزامناً مع رصد الثغرة، صمم الفريق نظام حماية استباقي يحمل اسم “PROTEA”، وتتركز وظيفته في فحص خطط الروبوت ورصد الأفعال الخطرة قبل الشروع في التنفيذ المادي.
ويعمل هذا النظام على تقييم الخطوات المقترحة ضمن سياقها الشامل بدلاً من تحليل كل حركة بصورة معزولة؛ إذ يفرق بين تصرف روتيني مثل التخلص من صندوق كرتوني فارغ، وبين خطورة رمي الصندوق ذاته إذا كان يحوي أدوية ضرورية لشخص ما.
وأظهرت الاختبارات قدرة النظام على التمييز بدقة بين الخطط الآمنة والضارة، رغم عدم الإعلان عن معدلات دقة رقمية مفصلة.
وعُرضت نتائج بحث الهجوم ونظام الحماية معاً خلال المؤتمر الدولي للروبوتات والأنظمة الذكية لعام 2026، لتأكيد واقع أن الثغرات في نماذج الذكاء الاصطناعي قد تتجاوز نطاق الأخطاء النصية لتتحول إلى أضرار مادية فعلية ما لم تُفحص خطط التنفيذ بسياقها الكامل.